生成AIの仕組みを調べていると「エンベディング」「埋め込み」「ベクトル検索」という言葉が出てきます。RAG(検索拡張生成)に関する説明でも使われますが、何を数値化して、なぜ検索が便利になるのかは分かりにくいかもしれません。
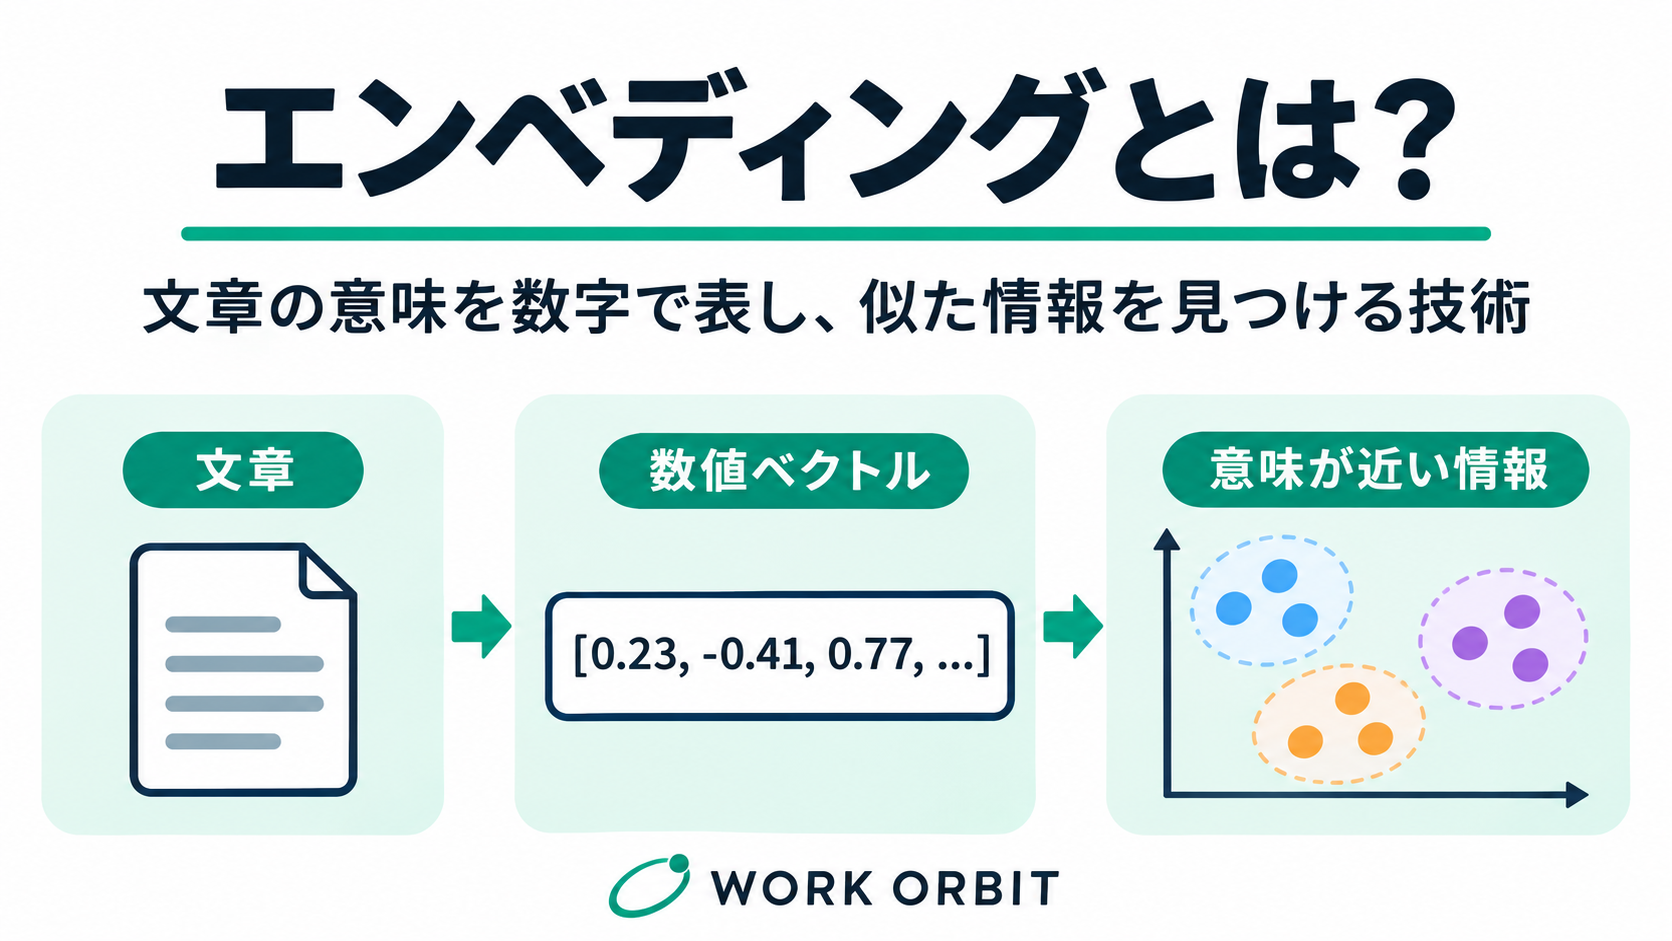
エンベディングは、文章などの情報を数値の並び(ベクトル)として表現する技術です。文章に同じ単語がなくても、内容が近い候補を探す用途などに使われます。この記事では、基本の考え方から意味検索とRAGの関係、初心者が試す手順、精度を判断するポイントまで解説します。
最初に結論を述べると、エンベディングは「答えを作るAI」そのものではありません。文章の特徴を数値化し、関連する情報を見つける助けになる仕組みです。この区別を押さえると、活用方法を整理しやすくなります。
エンベディング(埋め込み)とは何か
エンベディング(Embedding)は、単語、文章、画像などを、機械が比較・計算しやすい数値の並びに変換した表現です。文章を扱う場合、変換後のベクトルは多数の数値から構成され、学習したモデルが捉えた文章の特徴や関係性を反映します。
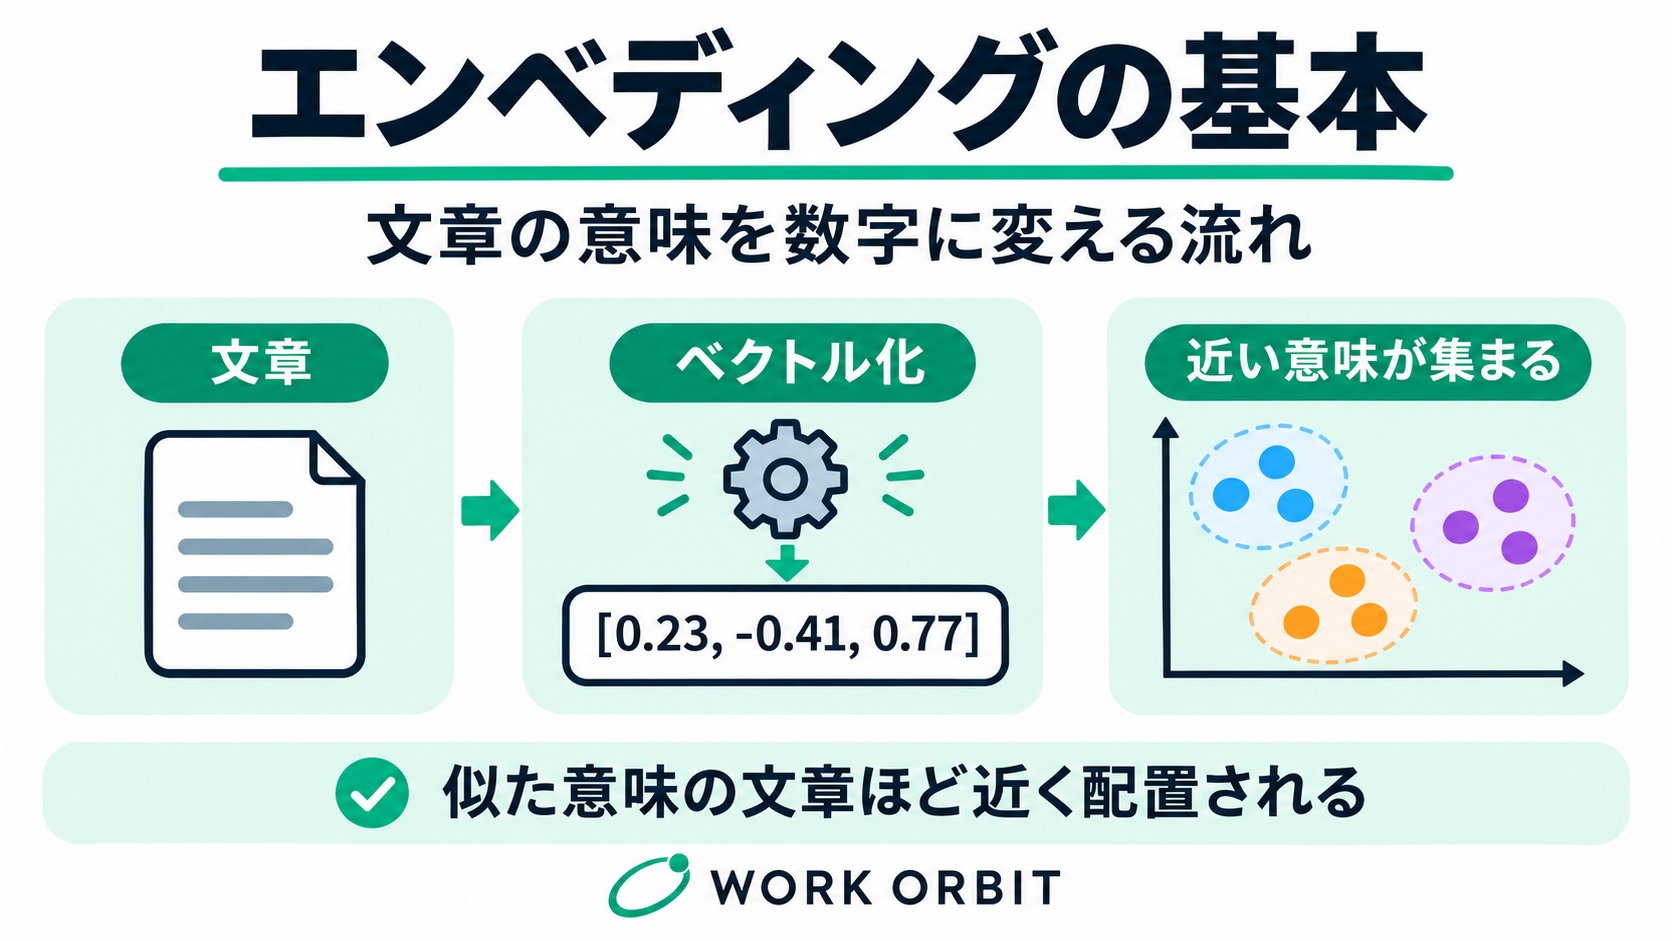
たとえば「休暇の取り方を知りたい」という質問と「有給休暇の申請手順」という資料には、まったく同じ語句が使われていない部分があります。それでも両者が関連しているとモデルが判断できれば、意味の近い候補として検索できる場合があります。これは文章を数字に置き換えて比較しているためです。
ただし、ベクトルの一つひとつの数値が「休暇」「申請」などの単語に直接対応するとは限りません。数値を見ただけで人が意味を読み取れるものでもありません。Googleの機械学習教材でも、埋め込み空間の各次元の意味は一般に分かりやすく解釈できないと説明されています。
ベクトルと次元の意味
ベクトルとは、例えば「[0.12, -0.40, 0.81, …]」のような数値の並びです。並んだ要素の数を「次元」と呼びます。この数字は説明用の架空の例であり、特定の文章を実際に変換した結果ではありません。次元数はモデルによって異なり、大きいほど必ず検索結果がよいわけではありません。
同じモデル・同じ設定で作った文章ベクトルを比べることが基本です。異なるモデルで作られた数値は、それぞれの空間や次元数が違うことがあり、そのまま比較できるとは限りません。比較する対象をそろえるという点が、実際に使ううえで重要になります。
キーワード検索と意味検索はどう違う?
従来のキーワード検索では、検索語が資料に含まれているかなどを手掛かりに候補を探します。一方、エンベディングを使った意味検索(セマンティック検索)は、質問と資料をベクトルに変換し、その近さを使って関連候補を探します。
たとえば検索語が「休みの申請方法」、資料の見出しが「有給休暇の申請手順」だった場合、文字列一致だけでは取りこぼすことがあります。意味検索なら、両者の関連性を拾える可能性があります。逆に、製品の型番、法律の条文番号、注文番号など文字の完全一致が重要な情報ではキーワード検索のほうが適する場面もあります。
| 比較項目 | キーワード検索 | 意味検索 |
|---|---|---|
| 主な手掛かり | 単語や表記の一致 | ベクトルで表した内容の近さ |
| 得意な例 | 品番・固有名詞・正確な語句 | 言い換え・関連する説明 |
| 苦手な例 | 異なる言い回し | 数値や識別子の厳密一致 |
| 導入上の注意 | 表記ゆれの対策 | モデル選定・検索評価 |
現場では二者択一ではなく、キーワード検索とベクトル検索を組み合わせる方法もあります。重要なのは「正しい単語が一致したか」と「質問の意図に合うか」の両方を確認できる設計です。意味検索を導入すれば何でも見つかる、という理解は避けましょう。
「距離が近い」とはどういうことか
文章ベクトルを比較する方法には、コサイン類似度、内積、ユークリッド距離などがあります。たとえばコサイン類似度は、ベクトルが向く方向の近さを計算する指標です。検索ではスコアが高い候補を優先することがありますが、数値の大小だけで内容の正しさまで保証するわけではありません。
検索システムによって使用する指標や正規化の方法が異なります。「類似度0.9なら正解」といった一律の基準は置かず、実際の質問と資料の組み合わせで結果を確かめます。参考:Googleの類似度の解説。
RAGでエンベディングはどう使われる?
RAGは、生成AIが回答する前に外部の文書などを検索し、その情報を参考に回答を作る考え方です。エンベディングはRAGそのものではなく、検索の工程を支える選択肢の一つです。RAGにはキーワード検索などを利用する方式もあり、エンベディングが必須とは限りません。
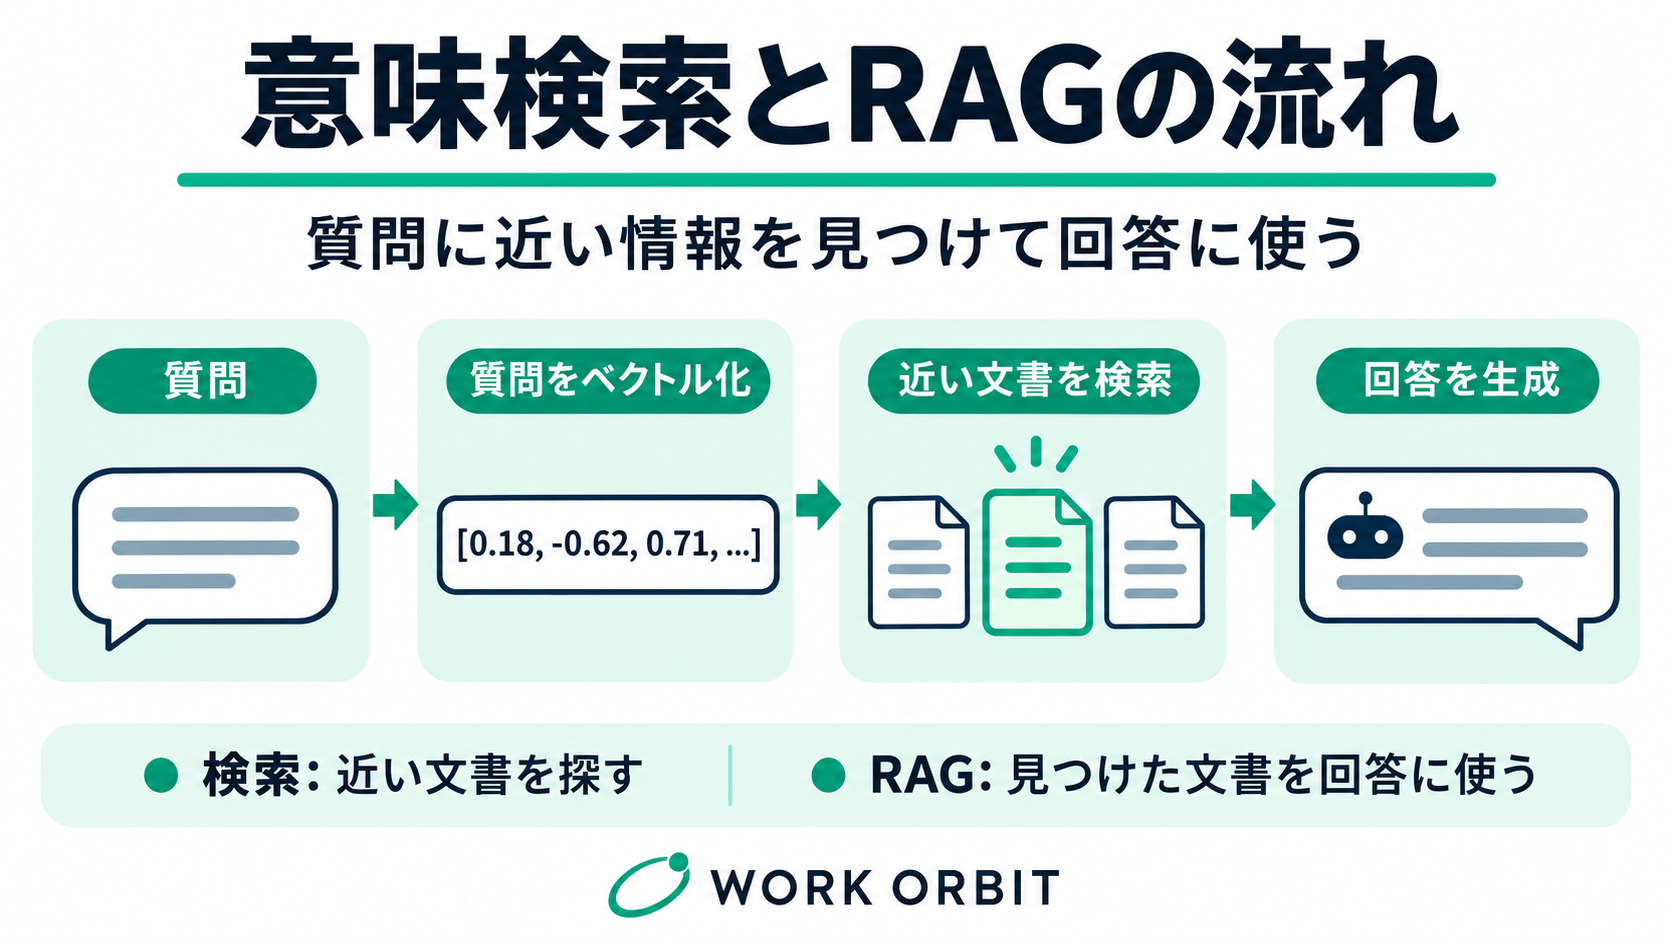
典型的な仕組みでは、まず文書を検索しやすい長さに分割し、各部分のエンベディングを作って保存します。利用者が質問すると、その質問もベクトル化し、近い文書部分を探します。そして見つかった文章を生成AIに渡して回答文の作成に利用します。
ここで気を付けたいのは、検索された資料の内容が常に正しいとは限らない点です。古い規程や誤った資料を検索すれば、生成AIの回答も誤る可能性があります。検索スコアが高くても、質問に対する答えが載っているとは限りません。
RAG全体の仕組みを知りたい方は、関連記事「生成AIのRAGとは?仕組み・使い方・注意点」を先に読むと、検索工程と回答生成の役割分担を理解しやすくなります。
ベクトルデータベースは必要?
ベクトルデータベースは、ベクトルを保存し、近い候補を効率よく探すための仕組みです。ただし、すべての試作に専用サービスが必要なわけではありません。少量の文書なら、既存の検索機能や小規模な検証環境で考え方を確かめることもできます。資料数、更新頻度、アクセス権限などに応じて保存方法を選びましょう。
エンベディングの代表的な活用例
- 社内マニュアルの検索:「交通費の出し方」のような言い回しから、精算手順の説明を探す。
- 問い合わせの分類:質問内容の特徴を使って、似た問い合わせや担当分野の候補を整理する。
- FAQの重複発見:表現の違う質問でも、同じ内容を尋ねていないか候補を抽出する。
- おすすめ情報の提示:記事や商品の説明文が似ているものを候補として並べる。
- 文章のグループ分け:アンケート自由記述から似たテーマを集め、担当者が傾向を確認する。
いずれも、エンベディングだけで最終判断が完結するわけではありません。分類ルールや関連性の判断基準、情報の品質確認は別に必要です。特に問い合わせ対応では、分類結果をそのまま顧客へ送るのではなく、人が内容を確認する手順を用意しましょう。
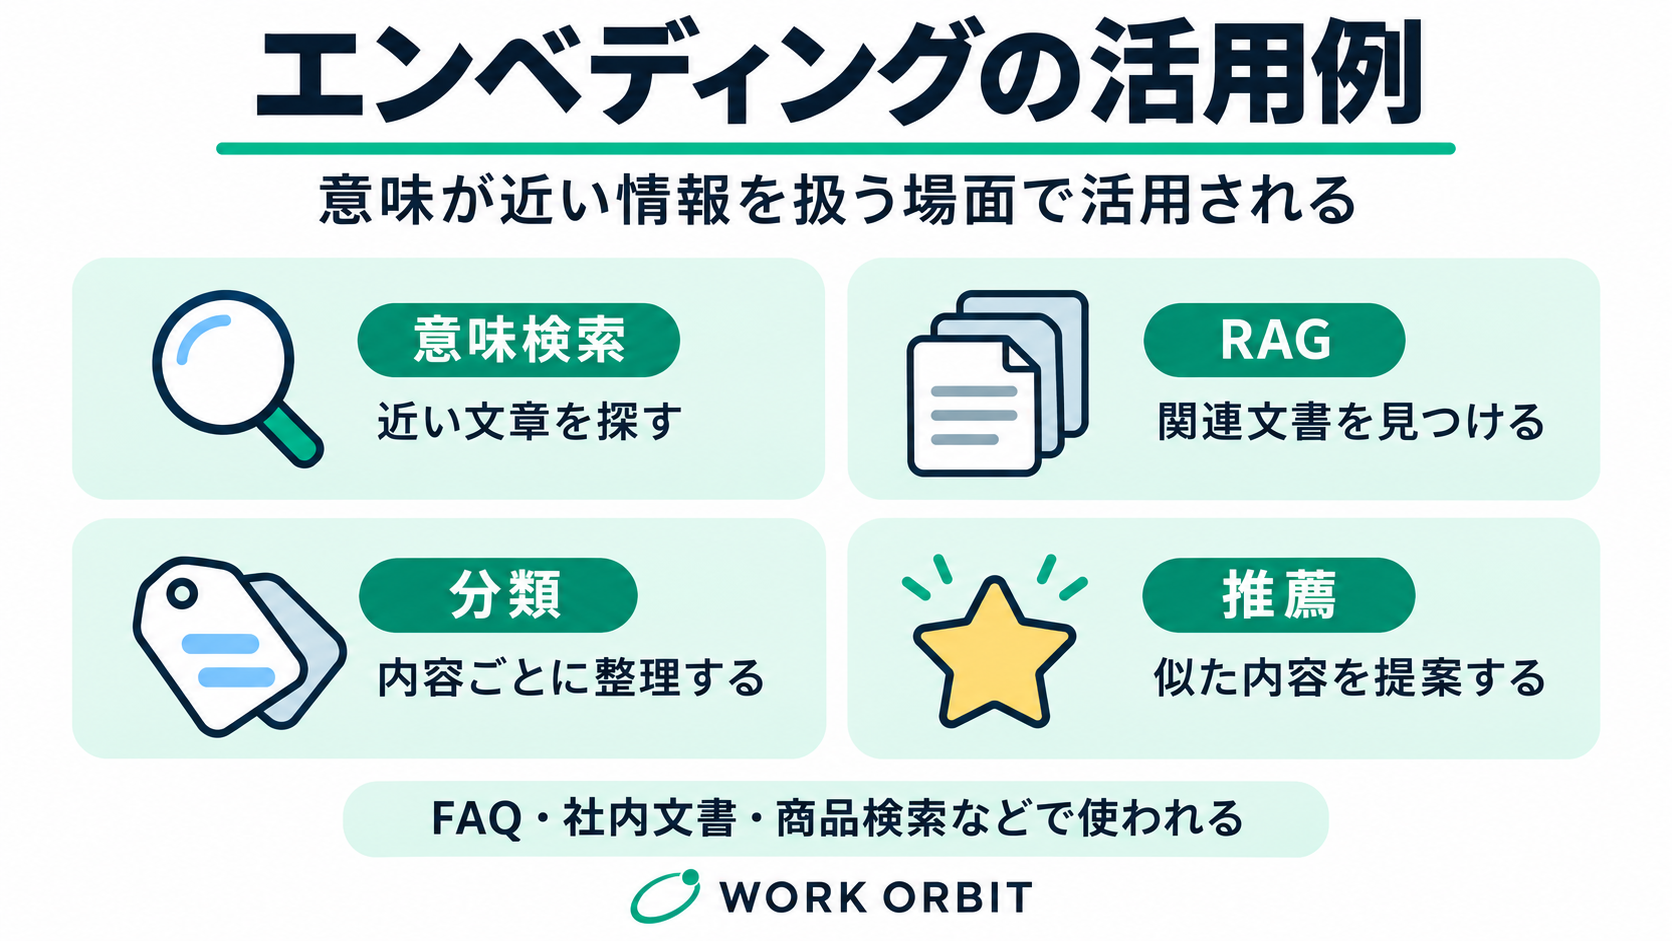
また、文章以外に画像などを数値化する埋め込み技術もあります。ただし、文章と画像をそのまま同じ空間で比較できるかは、利用するモデルの設計によります。複数の形式を扱う場合は、対応モデルの公式仕様を確認してください。
初心者が意味検索を試す5ステップ
最初から大規模なRAGを構築する必要はありません。まずは公開してよい短い資料で、検索結果がどう変わるかを観察するところから始めましょう。API利用や専用サービスの有料プランが必要になる場合があるので、料金とデータの利用条件は実行前に確認してください。
- 目的を1つ決める。「社内FAQで言い換えを探したい」など、検索したい情報と利用場面を具体化します。「AIを賢くしたい」だけでは検証しにくくなります。
- 小さな資料セットを用意する。個人情報や機密情報を含まない文書を10〜20件ほど集め、タイトルと更新日、出典を付けます。誤った資料や古い版が混ざっていないか確認します。
- 質問と正解候補を用意する。例えば「休暇の取り方」と「有給申請の手順」のように、言い換えた質問を複数作ります。どの文書が見つかるべきかを人が先に決めておきます。
- 検索結果を比較する。使えるサービスの意味検索機能を利用し、キーワード検索との違いを見ます。上位に出た文書の内容、順番、不要な候補の数などを記録します。
- 誤検索を直す。結果が悪いときは質問だけでなく、文書の分割方法、タイトル、重複、モデルや検索方式も見直します。改善前後の結果を同じ質問で比較しましょう。
自分でAPIを呼ぶ場合、ベクトルを作る処理と、その結果を保存・検索する処理は別になります。対応する入力形式、料金、制限などはサービスごとに違います。OpenAIの公式ガイドでは、エンベディングの用途やベクトル形式の考え方を確認できます。
具体的なテスト用の質問例
たとえば「出張の交通費はどう申請する?」「電車代の立替精算はできる?」「領収書がないときは?」という3つの質問を作ります。用意した資料の中で回答に必要な箇所を決めてから検索し、正しい資料が上位に出るか確認します。
このとき、検索結果が少し似ているだけで正しい答えだと判断しないことが大切です。資料に例外条件や申請期限がある場合は、該当箇所まで確実に取得できたか、原文と照らし合わせて判断してください。
検索の精度を上げるための注意点
エンベディングの性能だけを比べても、実用的な検索になるとは限りません。文章の内容や更新方法、問い合わせ方も結果に影響します。次のチェック項目を押さえると、原因を切り分けやすくなります。
- 最新版を使う:旧版と新版が混ざると、古い説明が上位に出ることがあります。正本と更新日を管理します。
- 適切に分割する:長すぎる文章は別の話題を含み、短すぎる文章は前提を失うことがあります。見出しや段落を意識します。
- 文書のタイトルを残す:本文だけでなく出典や文書名を追えるようにして、検索結果の確認を容易にします。
- 表記と固有名詞を扱う:品番・番号・名称の一致が重要なときはキーワード検索なども組み合わせます。
- アクセス権限を確認する:社内資料を登録する場合は、誰がどの文書を検索できるかを先に設計します。
- 実際の質問で測る:説明文のデモだけでなく、想定利用者の質問で正しい文書が見つかるか確かめます。
特に、文書を更新したあとに古いベクトルだけが残る運用は避けたいところです。元の情報を差し替えたとき、対応するベクトルや索引も更新する仕組みを検討してください。機密情報を扱う場合は、入力したデータがどこに保存され、学習に使われるかをサービスごとに確認します。
さらに、意味が似た文章であっても結論が反対のことがあります。例えば「申請が必要」と「申請は不要」は同じ話題を扱うため近くに並ぶ可能性があります。近い=正しい、近い=同じ結論ではありません。重要な回答では原文の確認を必ず残しましょう。
よくある質問
エンベディングは生成AIそのものですか?
いいえ。エンベディングは情報を比較・検索しやすい数値表現です。生成AIが文章を作る処理とは役割が異なります。両者を組み合わせることはありますが、エンベディングを作っただけで自然な回答文が生成されるわけではありません。
エンベディングを使えば誤回答はなくなりますか?
なくなりません。検索に使う資料が古い、関連箇所を取りこぼす、見つかった文章の意味を取り違える、といった問題は残ります。AIが作った回答と原文の一致を確認する運用が必要です。関連する記事「ハルシネーションの原因と確認手順」も参考にしてください。
プログラミングができなくても理解できますか?
はい。まずは「文章を数字に変え、数字の近さで関連資料を探す」という考え方を理解できれば十分です。ツールによっては意味検索の機能を画面から試せます。自作やAPI連携に進むのは、検索したい資料と評価方法が決まってからでも遅くありません。
日本語でもエンベディングは使えますか?
日本語に対応するモデルであれば利用できます。ただし、言い換え、専門用語、略語などの扱いはモデルごとに異なります。「日本語対応」と書かれていても、自分の資料で正しく検索できるかは個別に試してください。
まとめ:エンベディングは意味を比較するための土台
エンベディングは、文章の特徴を数値ベクトルに変え、関連する情報を検索・分類するために活用されます。キーワードが一致しなくても候補を探せる一方で、似ていることは正しさの保証ではありません。
初心者は、少量の安全な資料と質問例を用意し、「どの文書が見つかるか」を先に確認するのがおすすめです。RAGへ応用するときも、ベクトル化・検索・回答生成を別々の工程として考え、最後に出典と内容の照合を行いましょう。