生成AIを業務で使っていると、「自社の用語や文章の書き方を覚えさせたい」「毎回同じ指示を入力するのが面倒」と感じることがあります。こうしたときに候補となるのが、生成AIのファインチューニングです。
ファインチューニングとは、既存のAIモデルに追加のデータを学習させ、特定の目的に合わせて出力の傾向を調整する方法です。ただし、情報を追加する方法としてはRAGやプロンプトもあり、すべての人に必要なわけではありません。
この記事では、ファインチューニングの基本的な仕組み、RAGやプロンプトとの違い、向いているケース、導入前の確認ポイントを初心者向けに解説します。読み終えるころには、自分の目的にファインチューニングが必要か判断できるようになります。
生成AIのファインチューニングとは
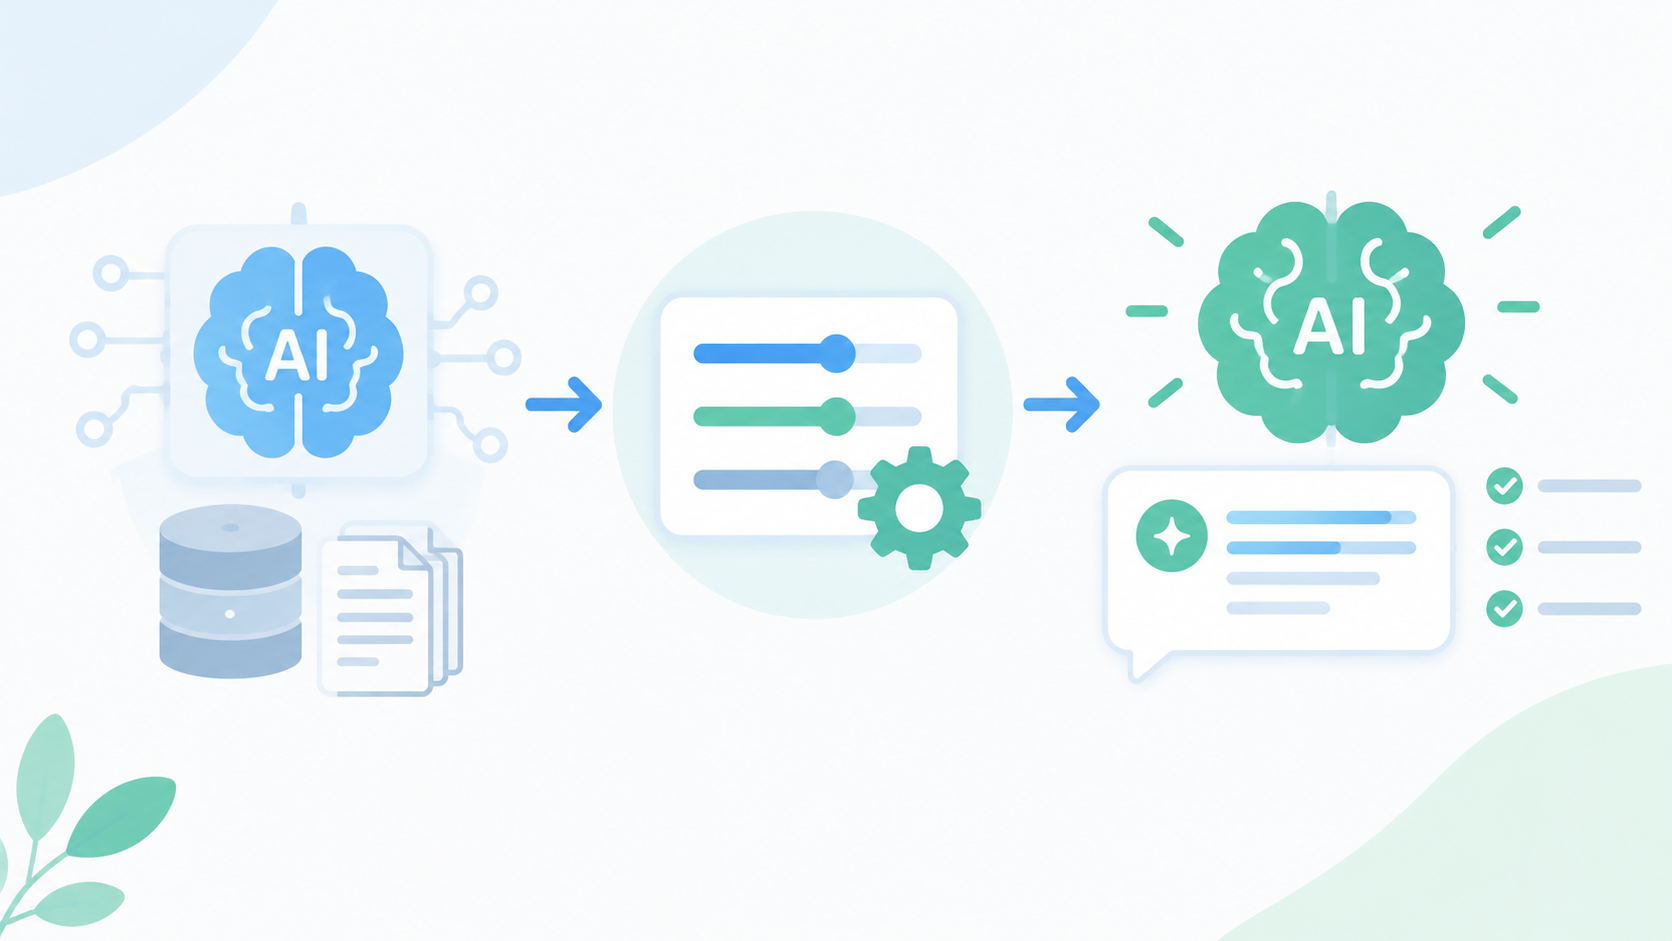
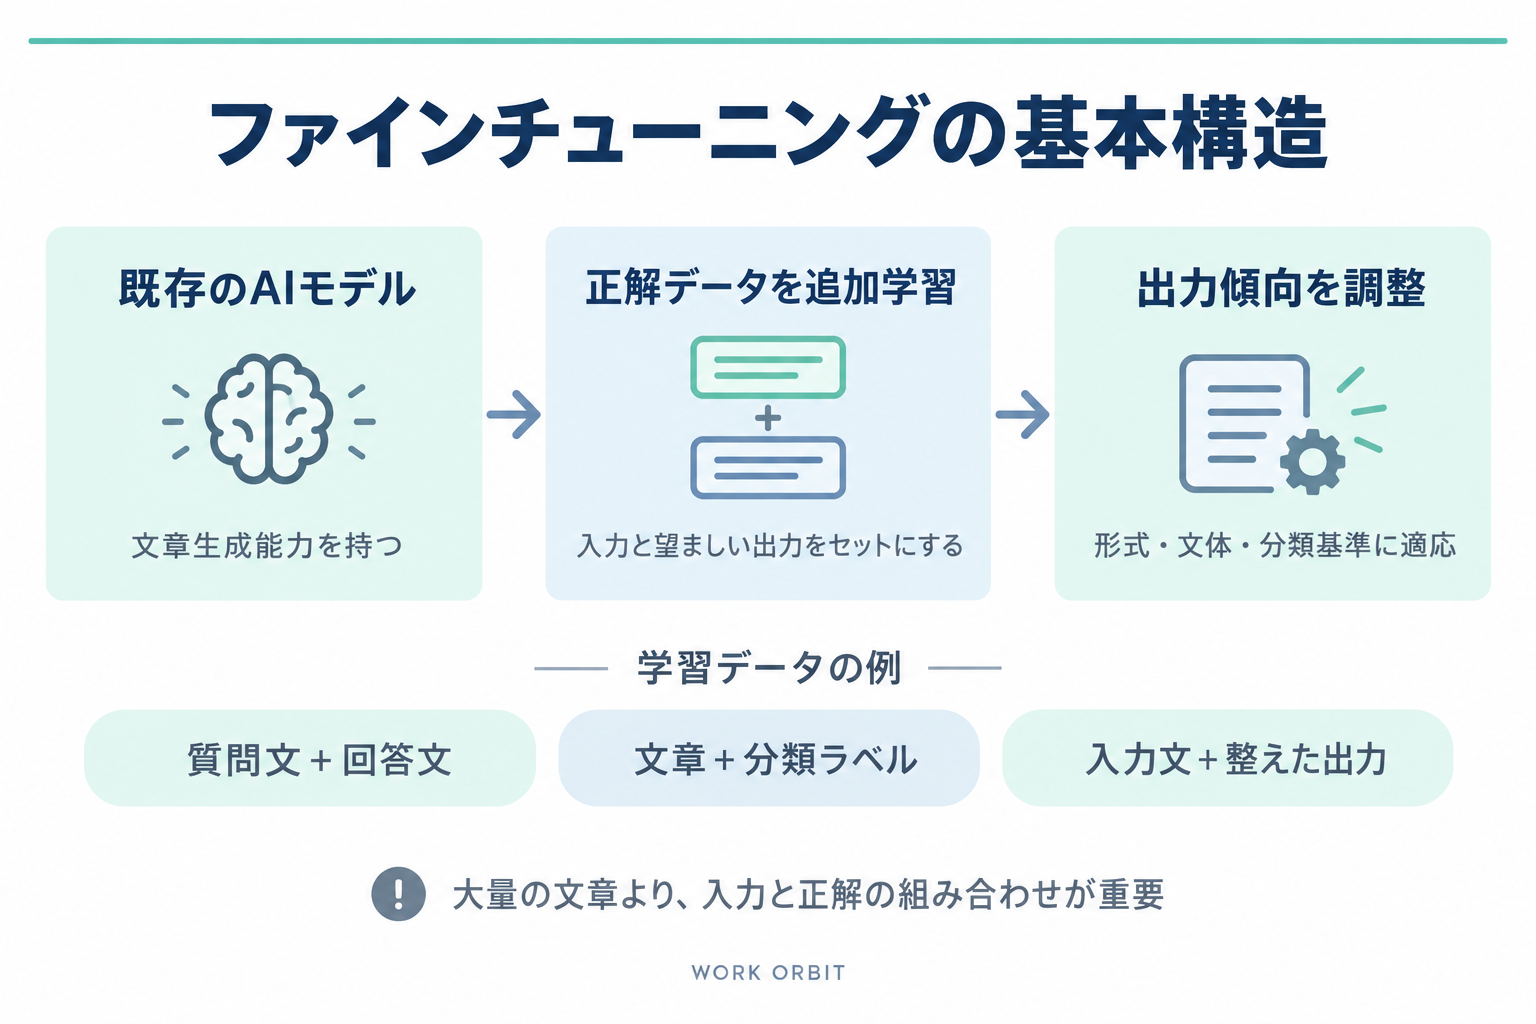
ファインチューニングは、すでに学習済みのAIモデルに、目的に合った追加データを学習させる方法です。一般的なAIモデルが持つ文章生成能力を土台にして、特定の回答形式や文体、分類基準などに適応させます。
たとえば、問い合わせメールを「緊急」「通常」「担当部署確認」の3種類に分類したいとします。過去の問い合わせ文と正しい分類結果を多数用意して学習させると、指定した分類ルールに沿った出力をしやすくできます。
学習させるデータの例
- 質問文と、それに対応する回答文
- 文章と、その文章に付ける分類ラベル
- 入力文と、望ましい形式に整えた出力文
- 専門用語を含む文章と、社内で統一した表現
重要なのは、単に大量の文章を渡すことではなく、「どの入力に対して、どのような出力を正解とするか」が分かるデータを用意することです。学習データの品質が低いと、誤った表現や一貫しない判断まで学習する可能性があります。
プロンプトで指示する方法との違い
プロンプトは、AIへの指示文をその都度入力する方法です。一方、ファインチューニングは、追加データを使ってモデルの出力傾向そのものを調整します。
毎回の指示で十分に対応できるなら、まずはプロンプトを改善するほうが手軽です。ファインチューニングは、同じ形式の処理を繰り返し、大量のデータで出力の一貫性を高めたい場合に検討します。
ファインチューニングとRAGの違い
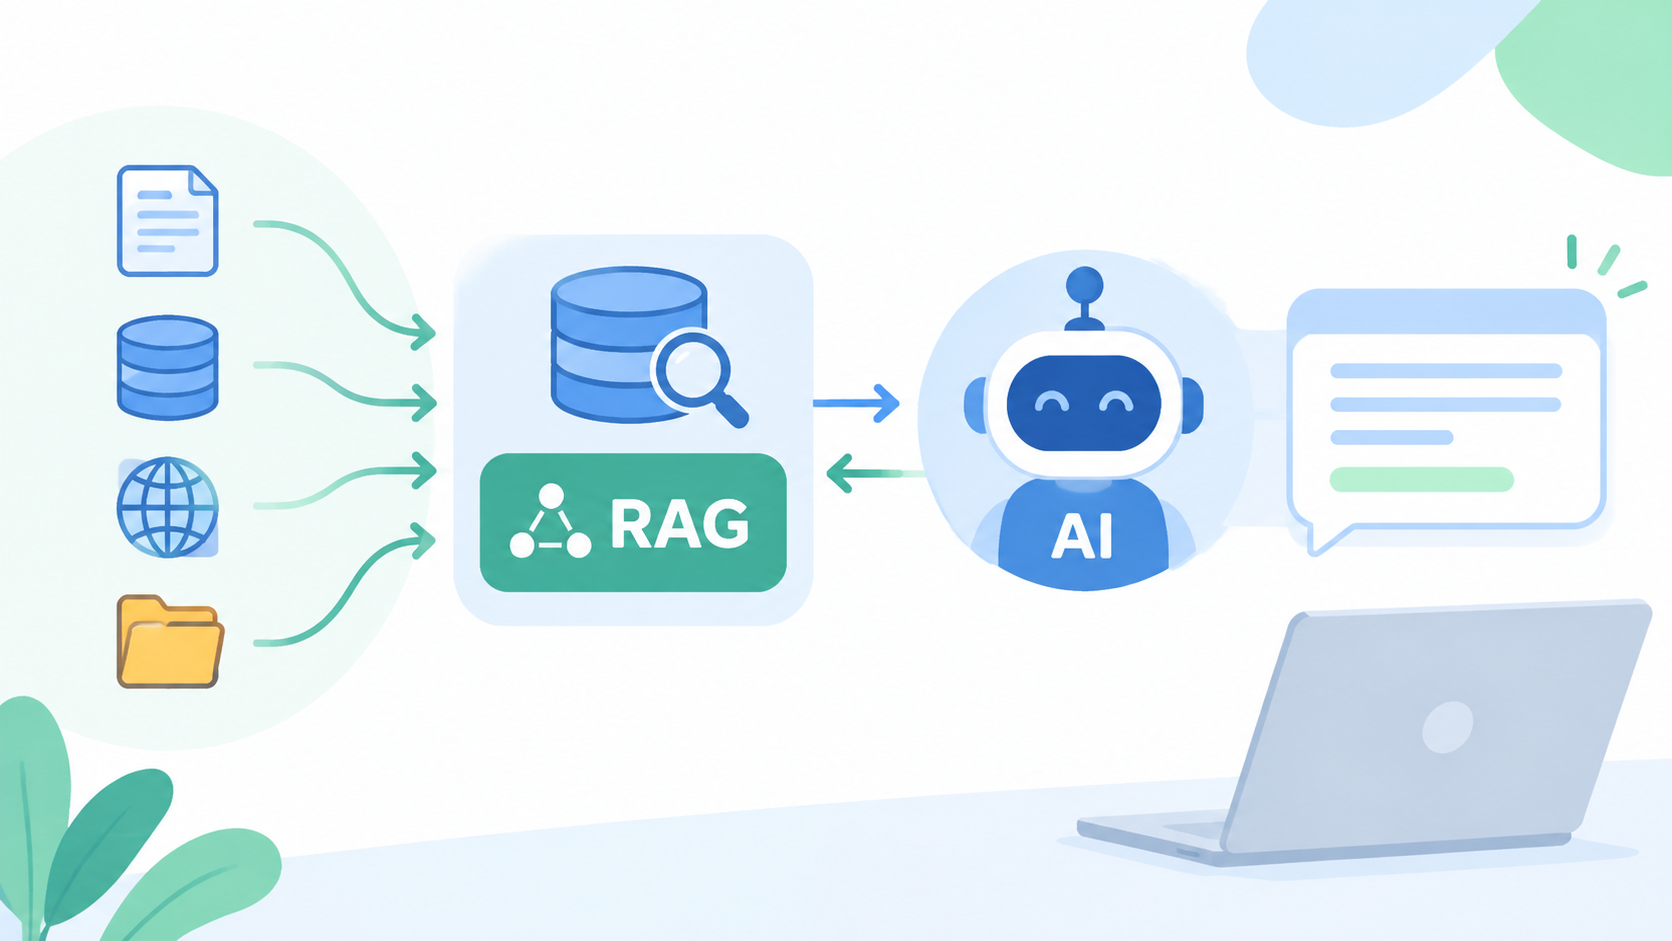
ファインチューニングと混同されやすい技術にRAGがあります。RAGは、AIが回答を作る前に、外部の文書やデータベースから関連情報を検索し、その内容を参考にして回答する仕組みです。
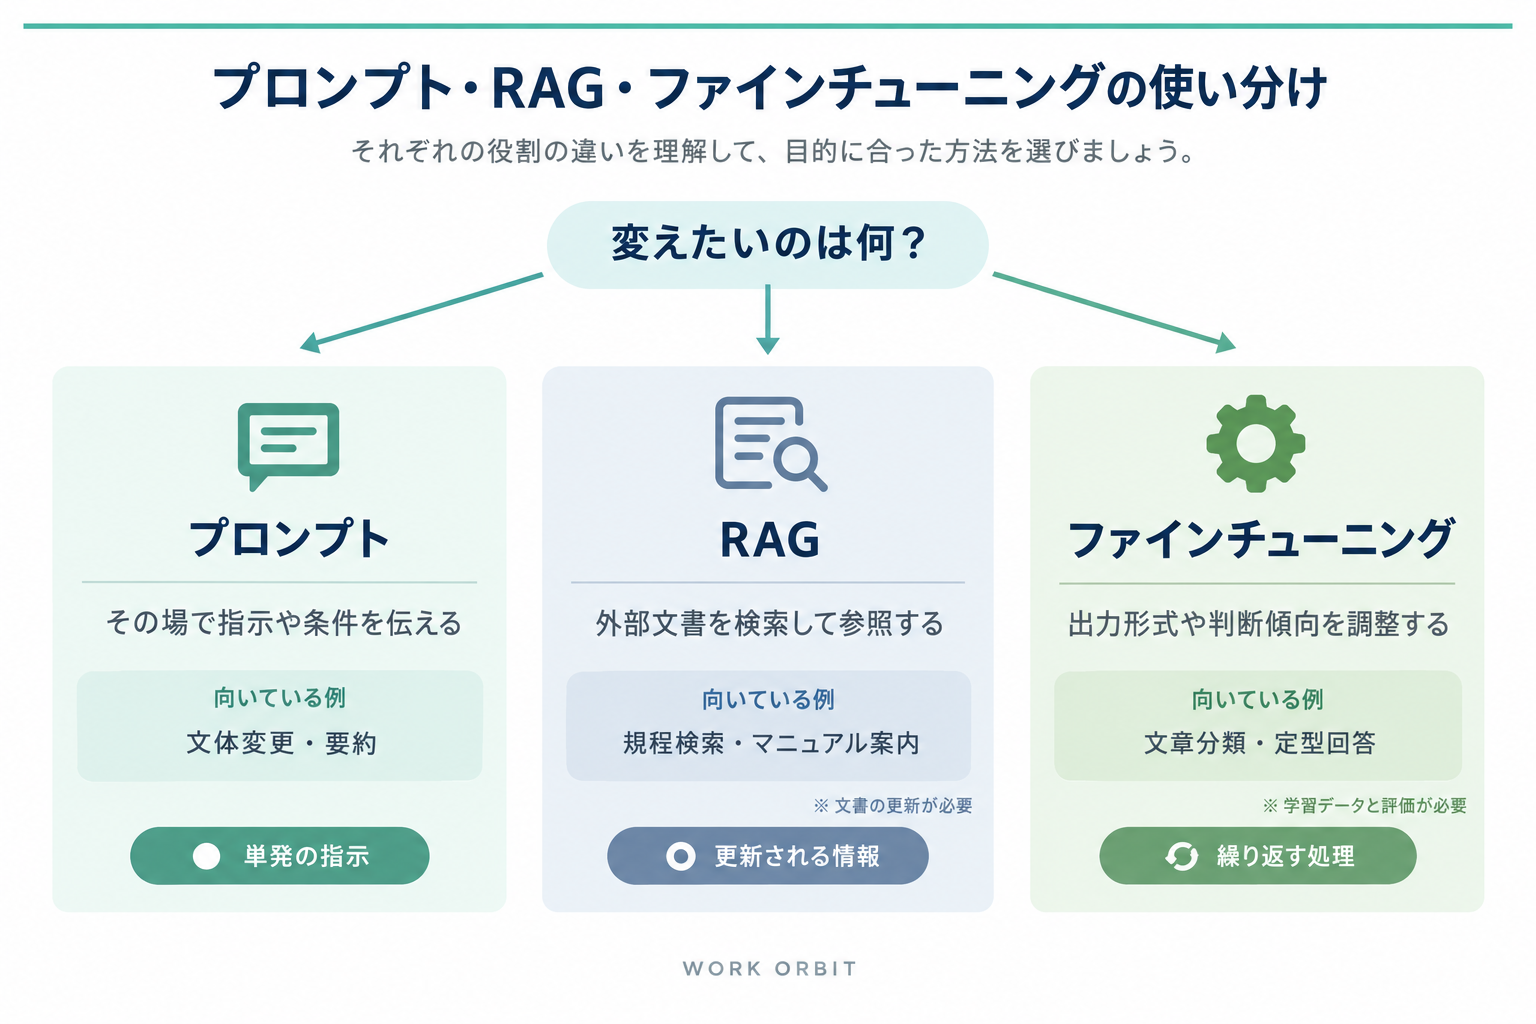
| 方法 | 得意なこと | 向いている例 | 注意点 |
|---|---|---|---|
| プロンプト | その場で指示や条件を伝える | 文体変更、要約、アイデア出し | 入力する指示によって結果が変わる |
| RAG | 最新情報や社内文書を参照する | 規程検索、マニュアル案内、資料への質問 | 検索対象の文書整備が必要 |
| ファインチューニング | 出力形式や判断傾向を調整する | 文章分類、定型的な回答形式、専門的な表現 | 学習データの準備と評価が必要 |
社内規程のように「内容が更新される情報」を参照させたい場合は、ファインチューニングよりRAGが適しています。モデルに情報を覚えさせても、規程が変更されたときに自動で最新状態になるわけではないためです。
RAGの仕組みを詳しく知りたい場合は、生成AIのRAGの仕組みや使い方を解説した記事も参考にしてください。
ファインチューニングが向いているケース
ファインチューニングが有力な選択肢になるのは、知識を追加したい場合というより、AIの出力パターンを一定にしたい場合です。
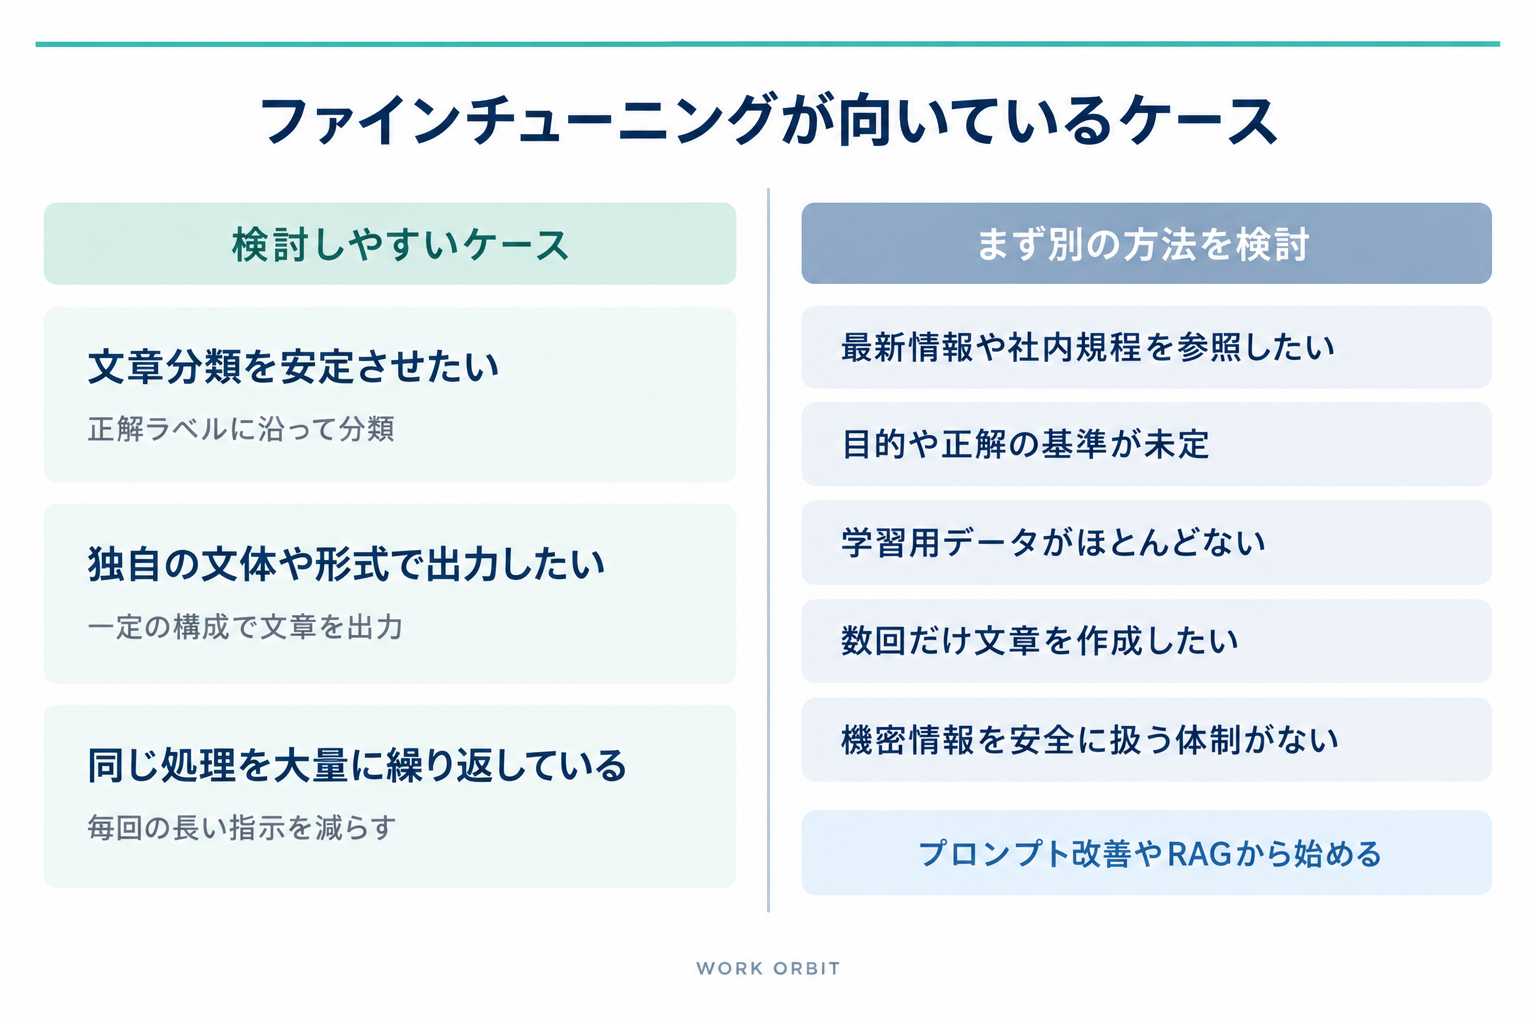
文章分類を安定させたい
問い合わせ、口コミ、アンケートの自由記述などを、あらかじめ決めたカテゴリに分類する業務に向いています。分類例と正解ラベルを用意することで、担当者ごとの判断のばらつきを減らすことが期待できます。
独自の文体や形式で出力したい
商品説明、社内報告、サポート返信など、入力内容が変わっても一定の構成で文章を出したいケースです。ただし、文章の品質や表現の最終確認をAIだけに任せるのは避けましょう。
同じ処理を大量に繰り返している
少数の作業ならプロンプトで対応できますが、同じ形式の処理を継続的に大量実行する場合は、毎回長い指示を入力する負担を減らせる可能性があります。
向いていないケース
- 最新のニュースや社内規程を参照したい
- まだ目的や正解の基準が決まっていない
- 学習用のデータがほとんどない
- 数回だけ文章を作成したい
- 個人情報や機密情報を安全に扱う体制がない
このような場合は、まずプロンプトの改善やRAGの検討から始めるほうが現実的です。AIツールを選ぶ基準については、AIツールの選び方を解説した記事も役立ちます。
導入前に確認する手順
ファインチューニングは、いきなり学習を始めるのではなく、小さな検証から進めることが大切です。
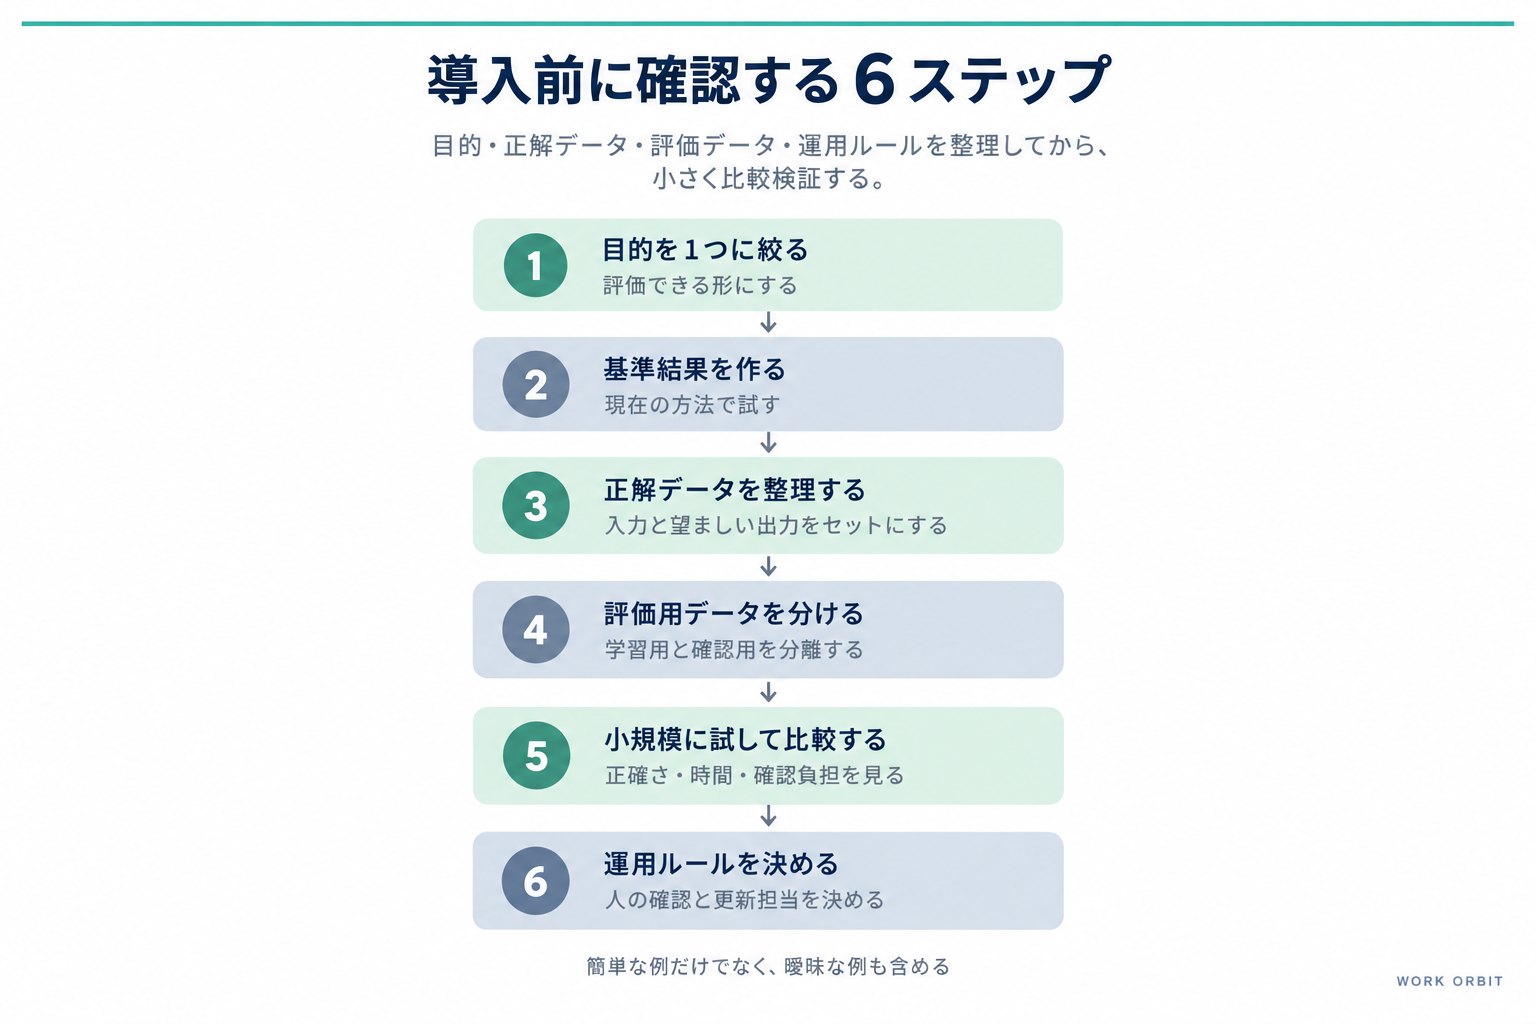
- 目的を1つに絞る
「回答を賢くする」ではなく、「問い合わせを5カテゴリに分類する」「商品説明を指定の構成で出力する」のように、評価できる目的にします。 - 現在の方法で基準結果を作る
既存のAIツールやプロンプトで処理し、どの程度うまくいくかを確認します。比較対象がないと、学習後に改善したか判断できません。 - 正解データを整理する
入力と望ましい出力をセットにします。表記ゆれ、誤分類、個人情報の混入がないか確認してください。 - 評価用データを分ける
学習に使うデータと、性能確認に使うデータを分けます。同じデータだけで確認すると、見慣れた例には答えられても、初めて見る入力に弱い可能性があります。 - 小規模に試して比較する
正解率だけでなく、誤った回答の種類、処理時間、確認にかかる手間も比較します。 - 運用ルールを決める
人が確認する範囲、誤りを修正する方法、データを更新する担当者を決めてから本番利用します。
最初の検証では、普段の業務から代表的な例を選びます。簡単な例だけでなく、表現が曖昧なものや複数のカテゴリに当てはまりそうなものも含めると、実運用での問題を見つけやすくなります。
失敗しやすいポイントと対策
ファインチューニングを実施しても、必ず期待どおりの結果になるとは限りません。特に初心者は、AIモデルの問題だと思っていた原因が、データや評価方法にあるケースに注意が必要です。
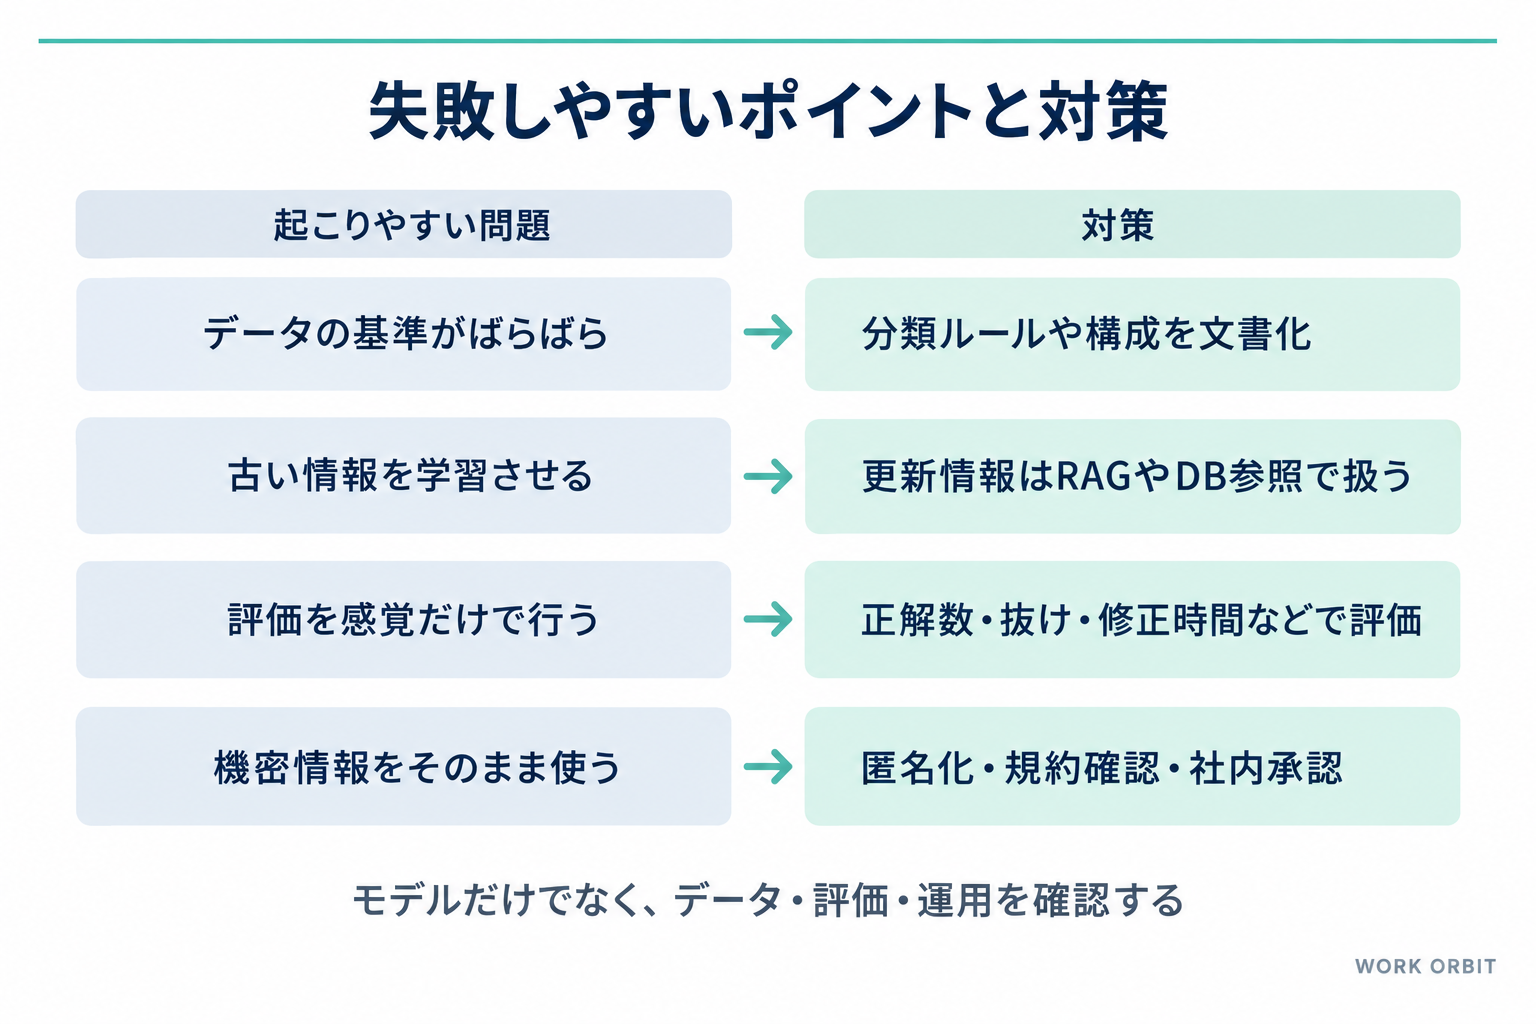
データの基準がばらばら
同じ種類の入力に対して、担当者によって異なる正解を付けていると、AIも判断に迷いやすくなります。先に分類ルールや文章の構成を文書化し、迷う例については判断基準を決めておきましょう。
古い情報を学習させてしまう
料金、担当部署、商品仕様など変更される情報を学習データに含めると、後から誤った内容を出力するおそれがあります。更新される情報はRAGやデータベース参照で扱い、学習させる情報と分けることが重要です。
評価を感覚だけで行う
「なんとなく自然に見える」だけでは、業務で使えるか判断できません。分類なら正解数、文章生成なら必須項目の抜け、禁止表現、修正時間など、目的に合った評価項目を設定します。
機密情報をそのまま使う
学習データに顧客名、連絡先、契約情報などを含める場合は、利用するサービスの規約やデータの取り扱いを確認してください。必要に応じて匿名化し、社内の承認を得てから扱います。
生成AIのファインチューニングに関するFAQ
ファインチューニングにはプログラミングが必要ですか?
利用するサービスによって操作方法は異なります。データの準備やAPIの利用でプログラミングが必要になる場合もありますが、重要なのはコードを書くことより、目的と正解データを整理することです。まずはプロンプトや既存機能で小さく検証すると、必要な技術レベルを判断しやすくなります。
ファインチューニングをすればハルシネーションはなくなりますか?
いいえ、なくなるとは限りません。ハルシネーションは、AIが事実と異なる内容を生成する現象です。ファインチューニングは出力傾向の調整に役立ちますが、事実確認や外部情報の参照を自動で保証するものではありません。
個人でもファインチューニングを使えますか?
利用できるサービスや条件は時期・サービスによって異なるため、公式情報の確認が必要です。個人で試す場合も、公開してよいデータだけを使い、費用、保存方法、利用規約を確認してから始めましょう。
まとめ
生成AIのファインチューニングは、追加データを学習させて、特定の出力形式や分類傾向に適応させる方法です。最新情報を参照したい場合はRAG、単発の指示ならプロンプト、繰り返し処理の出力を安定させたい場合はファインチューニングが候補になります。
- 目的を「出力形式」や「分類基準」まで具体化する
- 入力と正解データを整理し、個人情報や古い情報を除く
- 学習用と評価用のデータを分ける
- 本番導入前に、現在の方法と小規模に比較する
最初に取るべき行動は、改善したい業務から代表的な入力と理想の出力を10件ほど書き出すことです。そのデータを使ってプロンプトで試し、問題が「知識不足」なのか「形式のばらつき」なのかを見極めると、ファインチューニングが本当に必要か判断しやすくなります。